


把道德经、唐诗三百首、宋词三百首等古籍原文变成排版工整、可增量更新的 Anki 卡组 —— 全程在浏览器内生成
.apkg,数据不上传。
在线使用 · 无需安装、不用注册,打开就能生成卡组
一个古籍 → Anki 卡组的生成器。选书、选卡型、实时预览,浏览器内建库打包,下载 .apkg 直接导入 Anki 即可开始复习。
市面现成的古诗词卡组排版老旧、字段混乱、无法增量更新。本项目做的是:统一的数据模型 + 双卡型模板 + 稳定 guid,让卡组重新生成再导入时,Anki 按 guid 更新内容、保留原有复习记录。
生成全程在浏览器完成(sql.js 建库 + JSZip 打包),没有后端、没有上传。文本全部内置在 site/data.js,断网也能用。
内置 6 部古籍、1980 条笔记:道德经 554(81 整章 + 473 背诵)、唐诗三百首 640(320 首 × 背诵/赏析)、宋词三百首 566(283 首 × 背诵/赏析)、金刚经 204(32 分则赏析 + 172 背句)、心经 9、逍遥游 7。
- 双卡型设计 —— 背诵卡只问「上句 → 下句」,理解卡只问「原文 → 译文/注释/赏析」;靠模板
req控制出卡,两条线互不串扰 - 稳定 guid,增量更新不丢复习 ——
guidSeed经 FNV-1a 64 位散列生成 8 字符 guid,重新导入新版只更新内容、保留复习记录 - 牌组自动分层 ——
书::模式::序号 标题,每首诗/每一品独立成组,背诵与赏析分家,不混排 - 逐条实时预览 —— 选书选条目即时渲染正反面,可切夜间模式验证排版
- 模板可视化编辑 —— 背诵/赏析卡正背面 HTML + CSS 直接在页面改,存 localStorage,生成时生效
- 浏览器内生成 ——
sql.js建 SQLite 库、JSZip打包成.apkg,全程不联网 - 生成即自检 —— 下载前自动回读
dconf结构,缓存了旧版核心就拒发并提示强刷,避免导入失败 - 配置导入导出 —— 当前模板 + 所选笔记导出 JSON,换机可恢复
- 已通过 Anki 26.9.3 真实导入验收 —— 兼容性踩坑见「Anki 兼容性」
点击 在线使用 即可打开,无需安装、不用注册、不联网也能用(文本已内置在页面里)。
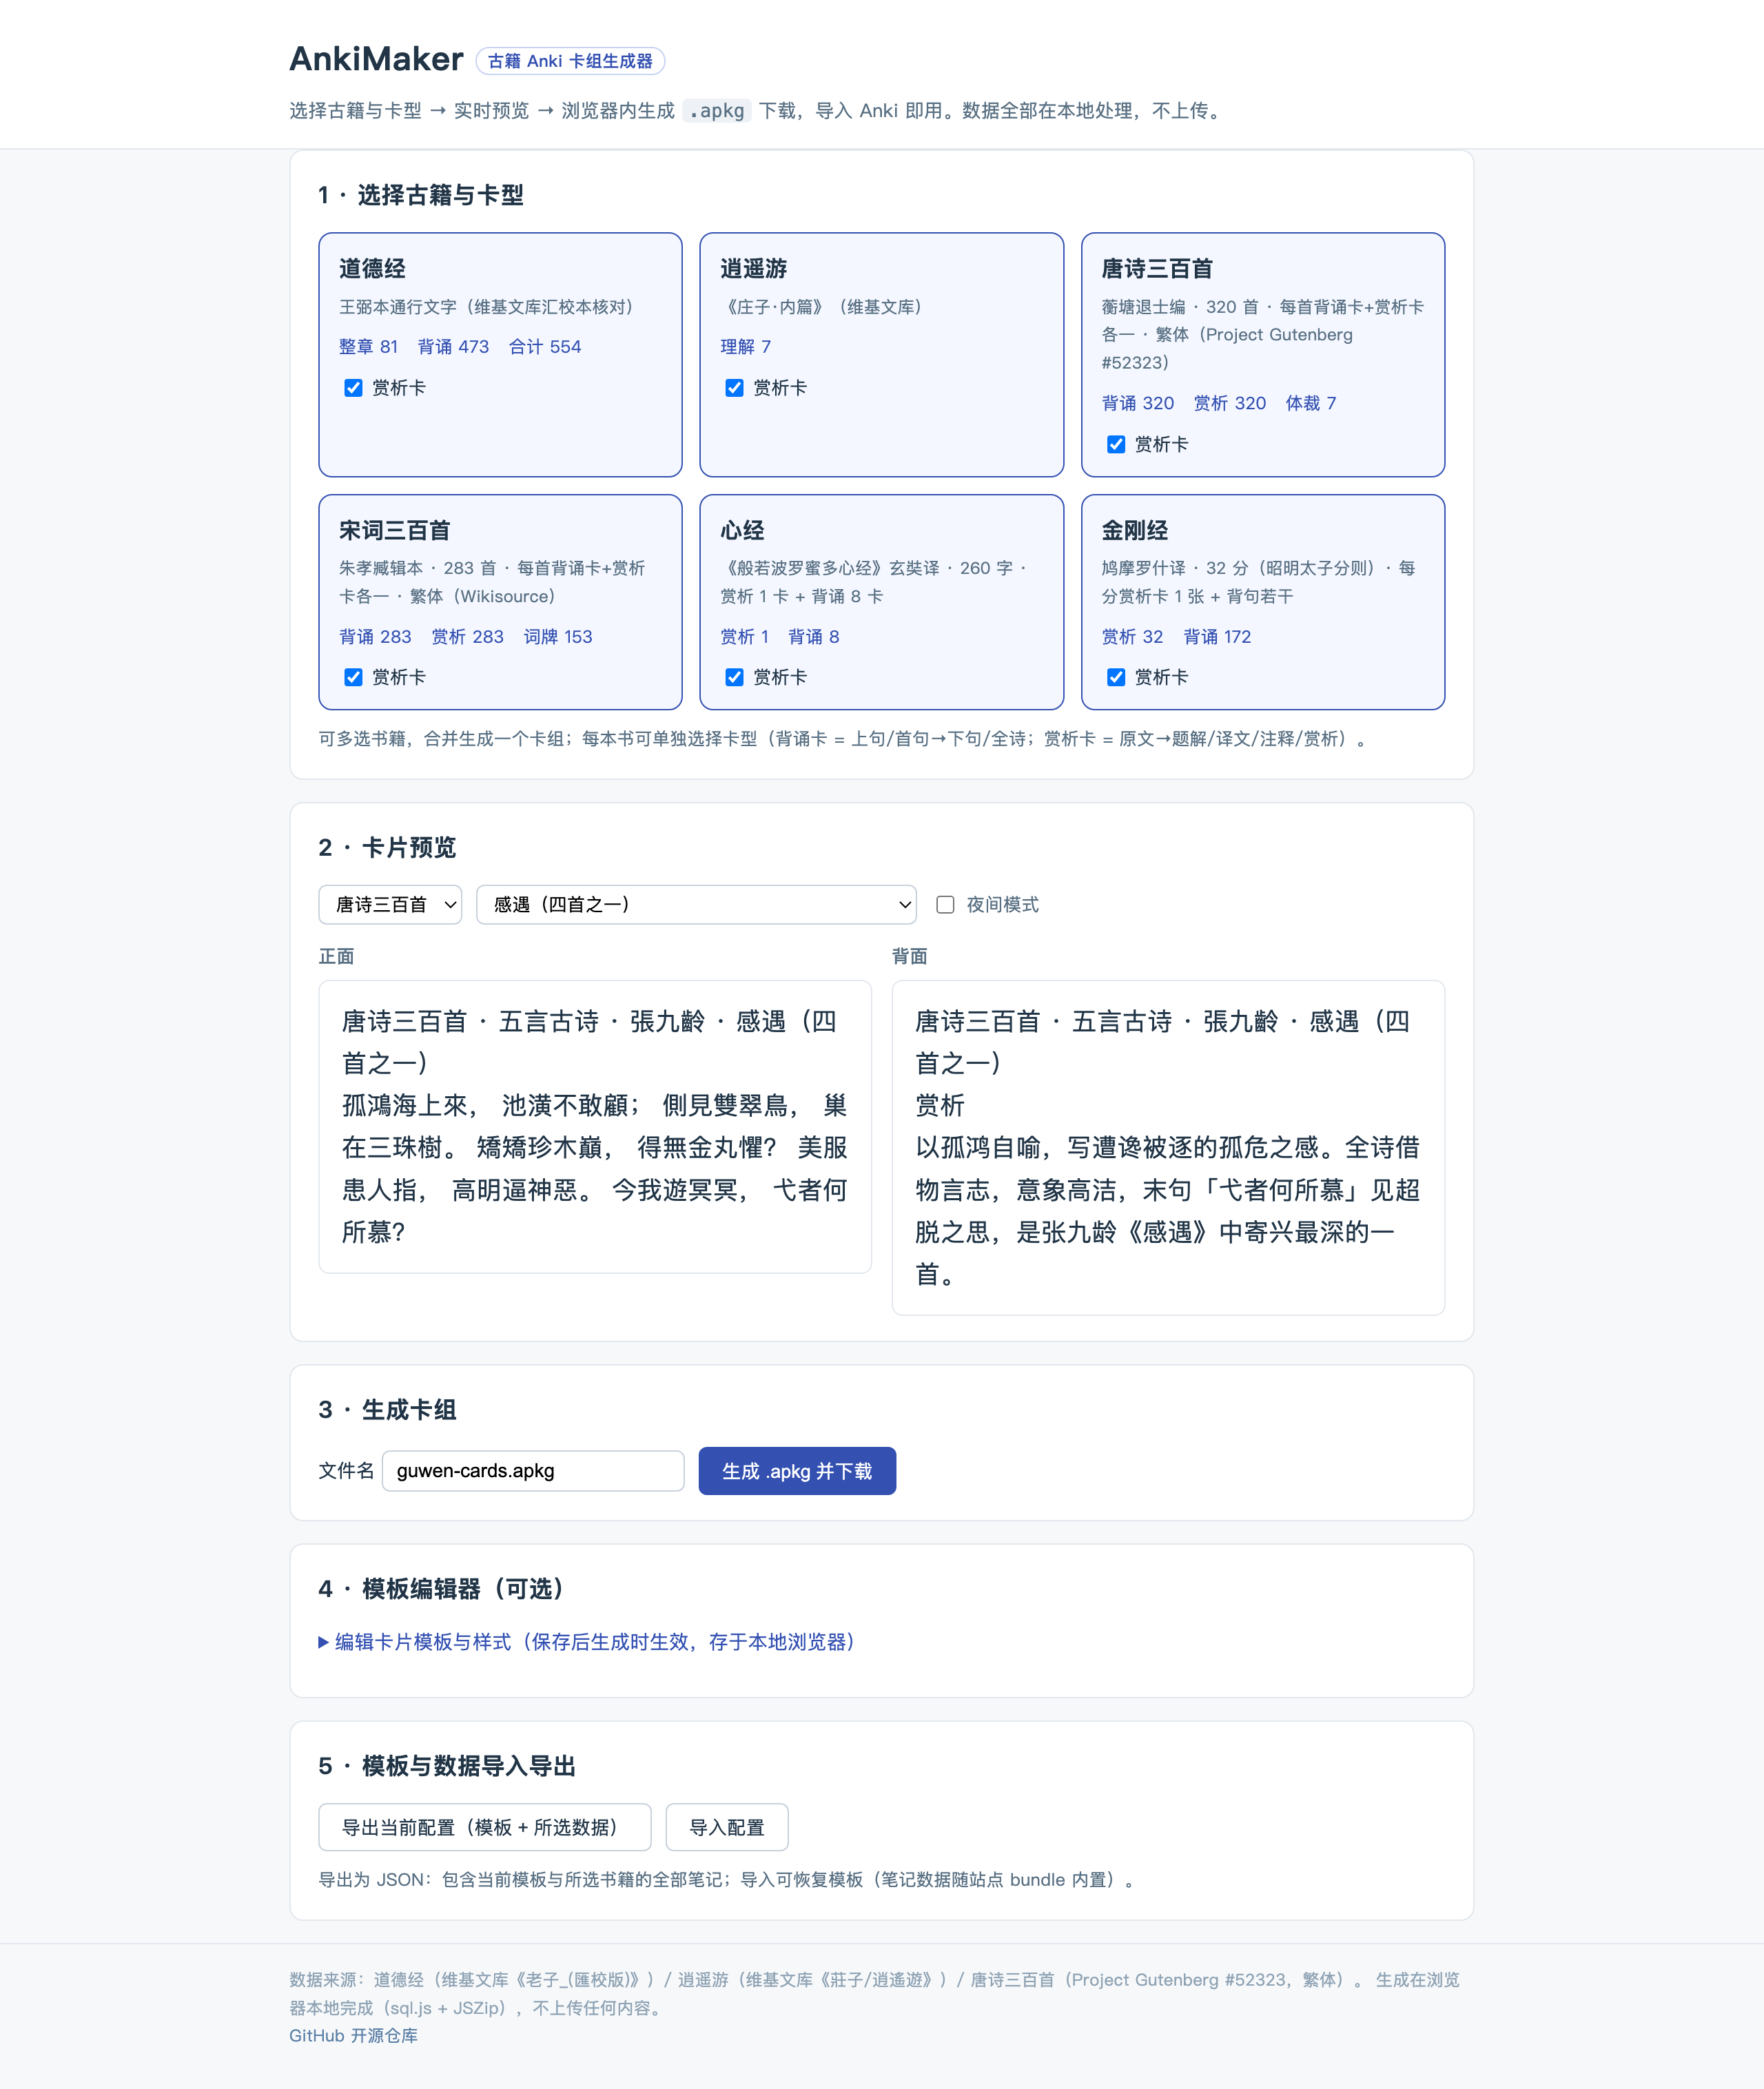
页面上四步:① 选书与卡型 → ② 预览 → ③ 生成 .apkg 并下载 → ④ 导入 Anki。
下载的 .apkg 用 Anki 的「文件 → 导入」载入。生成结果里会写明生成时间与原文来源,便于溯源。
想改数据或生成核心时才需要。项目是纯静态站,但 vendor/sql-wasm.wasm 需要 HTTP 环境(file:// 下会被浏览器拦),所以起个本地服务:
# 1. 安装依赖(sql.js / jszip / esbuild)
npm install

# 2. 改过数据或生成核心后,重跑打包
npm run build:site

# 3. 同步到 Pages 发布目录(docs/),并提交推送
bash tools/sync-site.sh

# 4. 起本地服务
cd site && python3 -m http.server 8000
# 然后打开 http://localhost:8000「古籍条目」共 9 个字段,其中 标题 为排序字段(sortf=1)。
| 字段 | 内容 | 背诵卡 | 赏析卡 |
|---|---|---|---|
| 篇目 | 完整定位路径,如「唐诗三百首 · 五言古诗 · 張九齡」 | 正面显示 | 正面显示 |
| 标题 | 卡内标题,如「感遇(四首之一) · 背句 01」 | 排序用 | 排序用 |
| 上句 | 提示句(诗:首句;文:拆分后上句) | 正面问句 | — |
| 下句 | 应答句(诗:全诗/全词;文:下句) | 背面答案 | — |
| 原文 | 全文 | 有则附「全文」区 | 正面问句 |
| 译文 | 白话翻译 | 有则显示 | 有则显示 |
| 注释 | 字词/典故注释 | 有则显示 | 有则显示 |
| 赏析 | 题解赏析 | — | 有则显示 |
| 链接 | 在线出处 | — | 有则显示 |
模板通过 req 数组控制出卡:背诵卡 req=[0,"any",[2]](上句 非空即出卡),赏析卡 req=[1,"any",[4]](原文 非空即出卡)。
「原文留空」的背诵条目只出背诵卡;「无上句」的整章条目只出赏析卡 —— 这是「一条笔记最多一卡」的关键,靠字段空值而非标签判断。
| 书 | 笔记数 | 拆分逻辑 |
|---|---|---|
| 道德经 | 554 | 一章两条线:整章卡(原文非空 → 赏析卡)+ 按 。!? 拆分的背诵卡(473 条) |
| 逍遥游 | 7 | 按段落拆,原文/译文/注释/赏析齐全,仅理解卡 |
| 唐诗三百首 | 640 | 每首两条:背诵条(首句 → 全诗)+ 赏析条(原文 → 题解) |
| 宋词三百首 | 566 | 同上,283 首 ×2;小序行单独入 注释 不混进正文 |
| 心经 | 9 | 赏析 1(玄奘译全文)+ 背诵 8(8 段,一段一卡) |
| 金刚经 | 204 | 按昭明太子 32 分则:赏析 32(分则提要 + 品旨)+ 背诵 172(按品拆句对) |
背诵卡的句对拆分有固定规则:排比句相邻配对;叙述句按「话题—述题」配对;对话体里的称呼与短问(「須菩提」「於意云何」)自动并入相邻句,不拆成孤立卡。
| 位置 | 元素 | 作用 |
|---|---|---|
| 顶部 | 标题栏 | 项目名与流程说明 |
| 步骤 1 | 书籍卡片 | 显示统计与来源;点卡片切换选中,每本可单独勾选卡型 |
| 步骤 1 | 卡型复选框 | 「背诵卡」/「赏析卡」,可多选合并生成 |
| 步骤 2 | 书/条目下拉 | 选书与选具体条目 |
| 步骤 2 | 夜间模式开关 | 切换卡片预览的深浅主题 |
| 步骤 2 | 正面/背面双栏 | 按当前模板实时渲染,条件块按字段自动显隐 |
| 步骤 3 | 文件名输入 | 默认 guwen-cards.apkg |
| 步骤 3 | 生成按钮 | 建库打包并下载,完成后显示笔记/卡/牌组数与体积 |
| 步骤 4 | 模板编辑器 | 改 4 段模板 HTML + CSS,可保存或恢复默认 |
| 步骤 5 | 导入导出 | 配置导出为 JSON、导入恢复模板 |
| 底部 | 数据来源与仓库链接 | 原文出处、隐私说明、GitHub 仓库入口 |
页面无键盘快捷键,全部操作走鼠标点击。
Anki 用 guid 识别笔记唯一性。稳定则重新导入只更新内容,保留复习记录:
guidSeed  "tang300:001:01"        ← 稳定身份(书:序号:类型)
   ↓ FNV-1a 64 位(BigInt 运算)
   ↓ 映射到 Anki base91 字符集
   ↓ 取 8 字符
guid      "Kx7mQ2pR"               ← 写入 notes 表,跨版本不变
牌组 id 同理由牌组名派生(stableDeckId(name)),重复生成不会创建重复牌组。
唐诗三百首                    ← 主牌组
└── 五言古诗                  ← 按体裁
    └── 01 感遇(四首之一)   ← 每首诗独立牌组
唐诗三百首
└── 赏析
    └── 01 感遇(四首之一)   ← 背诵与赏析分家
deckPath 统一 书::模式::序号 标题。每首诗/每一品一牌组,不混排;多书批量合并时主牌组自动聚合。
CSS 为卡片排版基线:系统字体栈、18px、行高 1.7、max-width: 40em 居中左对齐,日间 #213547 / 夜间 #1b1b1f,链接 #3451b2。夜间规则同时匹配 nightMode(新)与 night_mode(旧)两个类名,兼容不同 Anki 版本。
原文 → 结构化条目由解析器完成,行级状态机处理 Gutenberg / Wikisource 的排版差异:
| 源 | 格式 | 解析要点 |
|---|---|---|
| 唐诗三百首 | Gutenberg #52323,每行一句 | 3 位序号 → 长题跨行拼接 → 作者: 行 → 诗句行 |
| 宋词三百首 | Wikisource <poem> 块 |
标题行(词牌·副题 + 作者)→ 正文拼接;小序行单独入字段 |
| 道德经 | 按标点拆分 | 排比句相邻配对、叙述句话题—述题配对、单句并入下句 |
体裁推断(Gutenberg 文本无体裁字段):句长纯净(全 5 或全 7 字)按「句数 × 字长」判五/七言 × 绝句/律诗;混合字长归古诗;含 6 字以下短句(3+3 句式)判杂言古诗。共 7 类。
以下问题均在 Anki 26.9.3 真实导入中逐个踩过并修复,每条都是「不这么做就导入失败或错乱」:
| 报错 / 现象 | 根因 | 修法 |
|---|---|---|
JsonError: decoding deck config: missing field 'new' |
牌组配置缺新卡/复习参数 | 默认 dconf 补齐 new / rev / lapse 三组 |
…missing field 'rev' |
用了 Anki 2.1 老键 reviews/lapses |
按 schema v11 用 new/rev/lapse(兼容双写) |
JsonError: decoding decks |
decks JSON 的 key 用了字符串名 | key 必须为数字 DeckId,子牌组按父级数字 id 反查 |
| 导入成功但全部笔记挤进同一牌组 | deckId() 解析失败时兜底返回顶层 |
建立 idByName 反向索引 + conf 指认顶层牌组 |
| 导入后分组错乱 | 浏览器缓存旧包 + 主牌组命名冲突 | 生成前自检缓存并拒发;主牌组与子牌组严格分层 |
没有后端,不上传任何内容。 所有生成在浏览器本地完成,笔记文本内置于 site/data.js。
| 存储位置 | key | 内容 |
|---|---|---|
localStorage |
ankimaker:model |
模板编辑器改过的卡片 HTML 与 CSS |
这个 key 名容易误解:它只存模板,不存用户数据。笔记数据来自 site/data.js(随站点分发),不上传也不回写。
生成的 .apkg 直接存到浏览器下载目录,不经服务器。
AnkiMaker/
├── README.md
├── LICENSE
├── package.json
├── docs/                           # GitHub Pages 发布目录(由 tools/sync-site.sh 从 site/ 同步)
│   ├── screenshot.png              # README 配图(不经同步,单独维护)
│   └── og-image.png                # 1200×630 社交分享图
├── src/
│   ├── anki/                       # ★ 生成核心(网站与 Node 测试共用同一份)
│   │   ├── ids.js                  # 稳定 guid / 牌组 id / 纯 JS sha1 / csum
│   │   ├── schema.js               # Anki schema v11 DDL + 默认 conf/dconf
│   │   ├── db.js                   # sql.js 建库:col / notes / cards 写入
│   │   ├── pack.js                 # JSZip 打包 collection.anki2 + media
│   │   └── index.js                # buildApkg() 公开 API + 浏览器下载助手
│   ├── model/guwen.js              # 「古籍条目」笔记类型:9 字段 / 双模板 / 双主题 CSS
│   ├── parser/                     # 原文 → 结构化条目
│   │   ├── tang300.js              # 唐诗解析器(Gutenberg 行式文本)
│   │   └── song300.js              # 宋词解析器(Wikisource <poem> 块)
│   └── data/                       # 各书原文与结构化数据
│       ├── daodejing/              # ch1-37 / ch38-81 / recite(473 背句)
│       ├── zhuangzi/               # xiaoyao-you(7 段)
│       ├── tang300/                # raw.txt / index / appreciations(320 首题解)
│       ├── song300/                # raw.txt / index / appreciations(283 首题解)
│       └── fojing/                 # 心经 + 金刚经(32 分则) / notes / index
├── site/                           # ★ 静态网站(浏览器内生成 apkg)
│   ├── index.html / styles.css / app.js
│   ├── data.js                     # 全部笔记数据 bundle(内建,不上传)
│   └── vendor/                     # ankicore.js + sql-wasm + jszip
├── scripts/
│   ├── split_daodejing.mjs         # 道德经背诵卡拆分
│   ├── build_tang300.mjs           # 唐诗:解析 → 数据落盘 → 打包
│   ├── build_song300.mjs           # 宋词:解析 → 数据落盘 → 打包
│   ├── build_fojing.mjs            # 心经/金刚经打包
│   ├── build_texts_apkg.mjs        # 道德经 + 逍遥游打包
│   ├── check_data.mjs              # 结构化数据自检
│   ├── verify_apkg.py              # Python 独立回读校验(zipfile + sqlite3)
│   ├── extract_apkg_notes.py       # 从 .apkg 反解全部笔记为 JSON
│   ├── rebuild_data_from_apkg.mjs  # 从提取 JSON 重建 src/data/*.js
│   ├── bundle_site.mjs             # 站点资源打包(esbuild + 数据 bundle)
│   └── site-core.js                # 站点打包入口(re-export 核心)
├── tools/
│   └── sync-site.sh                # site/ → docs/ 同步 + 提交 + 推送(--check 只验不提交)
└── tests/
    └── anki.test.mjs               # node:test 生成与结构断言
npm test                  # node:test:生成 apkg → 解包 → 回读断言
npm run check:data        # 数据自检(字段完整性、guidSeed 唯一、牌组连续)
npm run build:site        # 数据自检 + 打包站点资源
npm run verify            # Python 独立回读样例包

# 站点发布(Pages 从 main 的 /docs 发布,源码在 site/)
bash tools/sync-site.sh          # 同步 site/ → docs/ 并提交推送
bash tools/sync-site.sh --check  # 只对比两边是否一致,不提交

# 单书构建 + 校验(可重跑)
npm run verify:texts      # 道德经 554 + 逍遥游 7 = 561
npm run verify:tang300    # 唐诗 640(329 牌组)
npm run verify:song300    # 宋词 566(569 牌组)
npm run verify:fojing # 心经 9 + 金刚经 204 = 213| 步 | 做什么 | 验收 |
|---|---|---|
| 1 | 取公共领域原文存 raw.txt,来源写入 META |
来源 URL + 授权状态有据 |
| 2 | 写解析器(原文 → 条目) | 试跑 0 异常、无模板残留;特例显式处理 |
| 3 | 定笔记结构(9 字段 + tags + deckPath + guidSeed) |
guidSeed 全局唯一;deckPath 形如 书::模式::序号 标题 |
| 4 | 落盘 + 打包 node scripts/build_<book>.mjs |
数据写 src/data/<book>/index.js |
| 5 | 双重校验 | check:data 全绿 + verify_apkg.py --expect-notes N 通过 |
| 6 | 并入网站 | bundle_site.mjs 加条目,选书页自动出现新书 |
guidSeed规则一旦发布就不能改 —— 改了等于换身份,Anki 会当成新笔记、复习记录全部作废src/anki/是网站与 Node 测试共用的同一份,不要在site/里另写一份生成逻辑- 改数据后必须重跑
npm run build:site,否则site/data.js与src/data/不一致 - 改完 UI 要重跑
npm run build:site——site/vendor/ankicore.js是 esbuild 产物,手改会在下次打包时被覆盖 docs/别手改 —— 它是 Pages 发布目录,改site/后跑tools/sync-site.sh;docs/screenshot.png(README 配图)不在同步清单里,单独维护- 换分享图改
site/og-image.png—— 站点用https://kingsir.work/AnkiMaker/og-image.png声明 OG/Twitter 卡片图,直接改docs/那份会在下次同步时被覆盖
在 Chrome / Edge / Safari 桌面版实测可用(站点开发环境为 Anki 26.9.3)。
- 需要 WebAssembly(
sql.js)与 ES2018+ 语法 - 线上版(kingsir.work/AnkiMaker)无需任何本地环境;只有自己改代码时才需要起本地服务
- 需要 HTTP 环境,直接双击
site/index.html不行(sql-wasm.wasm在file://下会被拦),必须起本地服务 - 移动端浏览器可用但界面未针对小屏优化,建议桌面访问
MIT © 2026 isnotry
文本来源:道德经与逍遥游取自维基文库(公有领域),唐诗三百首取自 Project Gutenberg #52323(蘅塘退士编,繁体),宋词三百首取自维基文库朱孝臧辑本(1924 年刊),心经与金刚经为公有领域经文。译文、注释、赏析为本项目整理。